主题
6.4 视觉对话接入
视觉对话是 JoyInside 的"语音 + 图像理解"场景:设备持续采集视频帧图像上传云端,智能体将图像写入会话上下文缓冲区,作为视觉感知数据参与对话。
适用于带视觉识别功能的玩具、机器人(狗)等具身场景。
6.4.1 整体链路
视觉数据通过 HTTP API 上报(不走 WebSocket 音频通道),但必须与 WS 对话的 sessionId 关联,云端才能把图像匹配到当前对话。
⚠ 视觉识别场景需先联系 JoyInside 运营人员协助申请开通权限,完成视觉识别智能体的接入。
6.4.2 WebSocket 建连参数
视觉对话的 WS 建联需额外带1个参数:needAsrPartial(开启ASR事件监听):
wss://ws.joyinside.com/soulmate/voiceChat/v1
  ?botId={botId}
  &sessionId={sessionId}
  &requestId={requestId}
&needAsrPartial=true| 参数 | 说明 |
|---|---|
needAsrPartial | 触发图片上传时机。传 true 时服务端下发语音识别 IS_START 事件,客户端监听此事件作为触发图片上传的时机。 |
6.4.3 图像上传时机
本地持续采集视频帧图像并缓存至本地,两种上传时机:
| 时机 | 方式 | 适用场景 |
|---|---|---|
| 定时上传 | 按每秒 1 帧方式,读取本地缓存视频帧图像上传 | 视觉实时感知的场景 |
| 事件触发上传 | 收到 JoyInside 下行 IS_START 事件后上传 | 减少链路开销,对视觉实时感知要求较低的场景 |
6.4.4 系统交互图
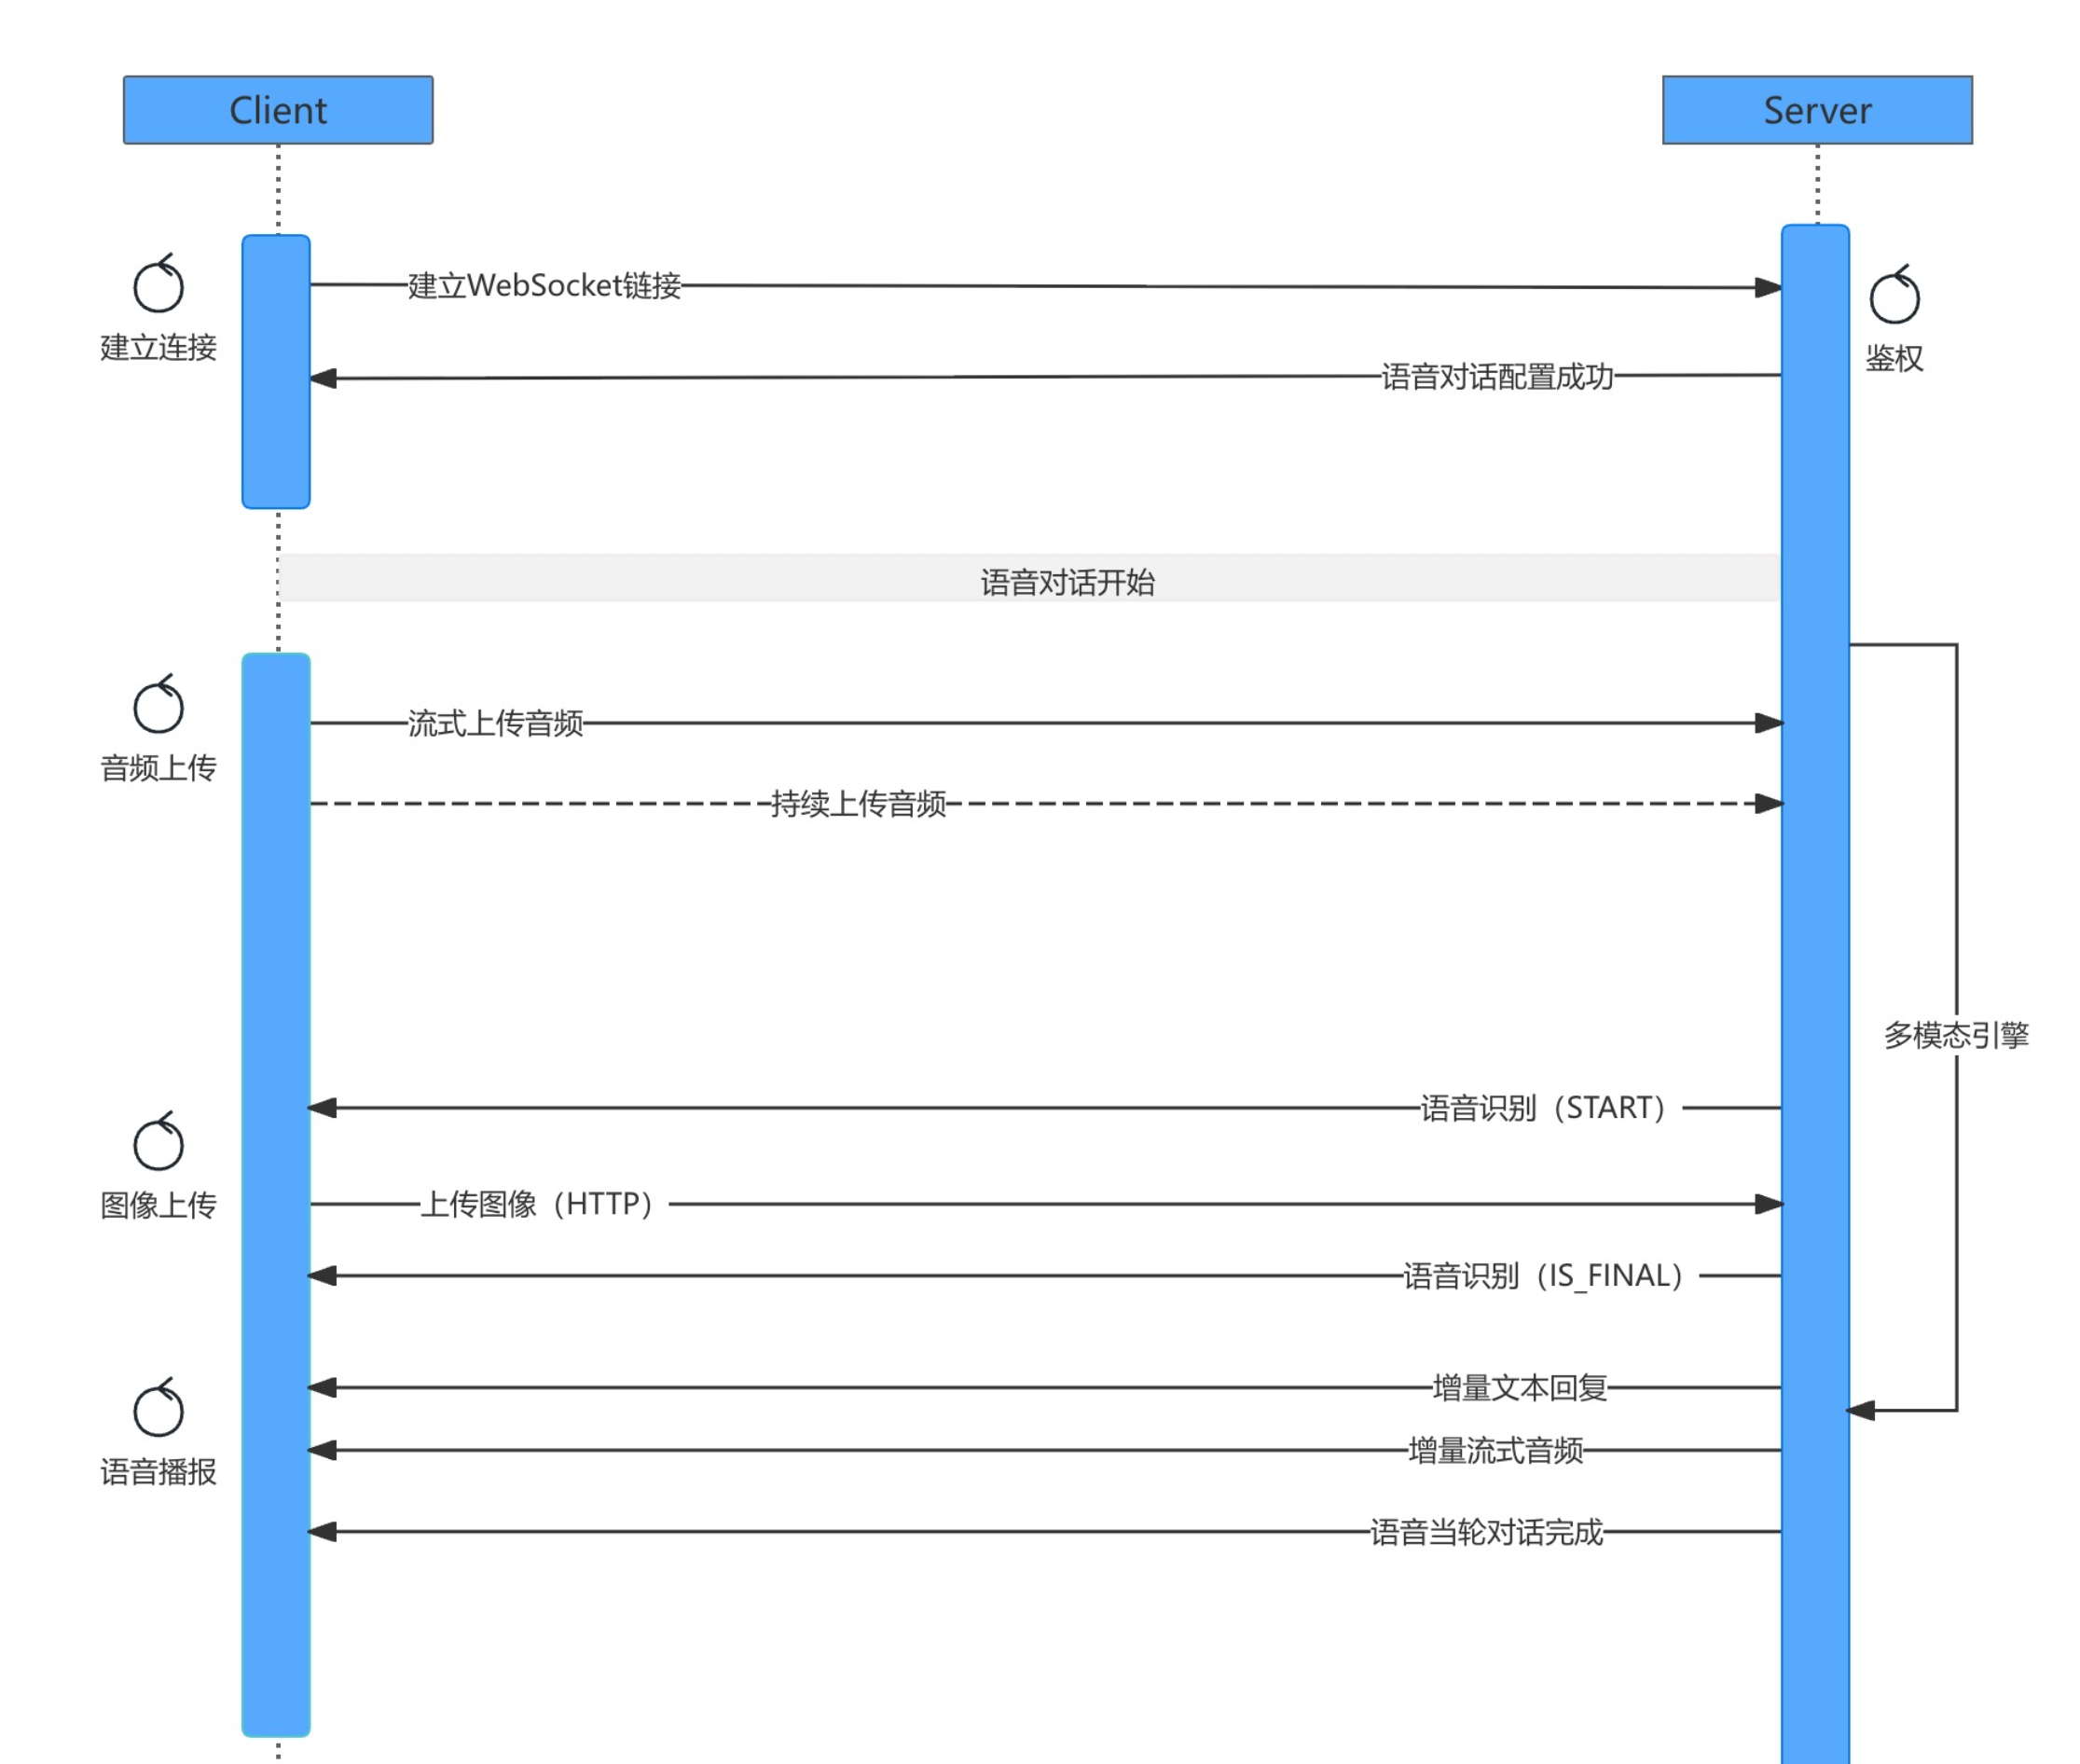
6.4.5 视觉图片上传 API
通过 API 方式上报客户端视觉采集图像,智能体将图像写入会话上下文缓冲区,作为视觉感知数据参与对话。
| 项目 | 说明 |
|---|---|
| URL | https://api.joyinside.com/vision/client/image/report |
| 请求方式 | POST |
| Header | Authorization: Bearer ${accessToken} |
| 权限说明 | 图像事件上报 |
⚠ 接口参数中
sessionId必须是 WebSocket 建连时的{sessionId},这样才能匹配到当前对话。sessionId 不一致会导致图像无法关联到对话上下文。
请求 Body
| 字段 | 类型 | 必选 | 说明 |
|---|---|---|---|
| requestId | String | 是 | 每次请求唯一标识,建议使用 UUID |
| botId | String | 是 | 终端设备唯一标识,每个终端用户必须用不同的 botId |
| sessionId | String | 是 | 当前会话唯一标识。相同 sessionId 智能体可自动加载会话上下文 |
| imgBase64 | String | 是 | 图像 Base64 字符串,JPEG 格式 |
| frameTimestamp | Long | 是 | 图像采集时间戳(单位:毫秒) |
响应
| 字段 | 类型 | 必选 | 说明 |
|---|---|---|---|
| state | String | 是 | SUCCESS 成功 / FAILURE 失败 |
| code | String | 是 | 0000 成功,其他错误码 |
请求/响应示例(点击展开)
请求示例:
json
{
  "requestId": "1",
  "botId": "1",
  "sessionId": "12345678",
  "imgBase64": "imgBase64==",
  "frameTimestamp": 1761899917136
}响应示例:
json
{
  "state": "SUCCESS",
  "code": "0000"
}6.4.6 接入步骤
- 平台注册:在 JoyInside 平台 完成注册,审核通过后完成基础配置
- 智能体接入:
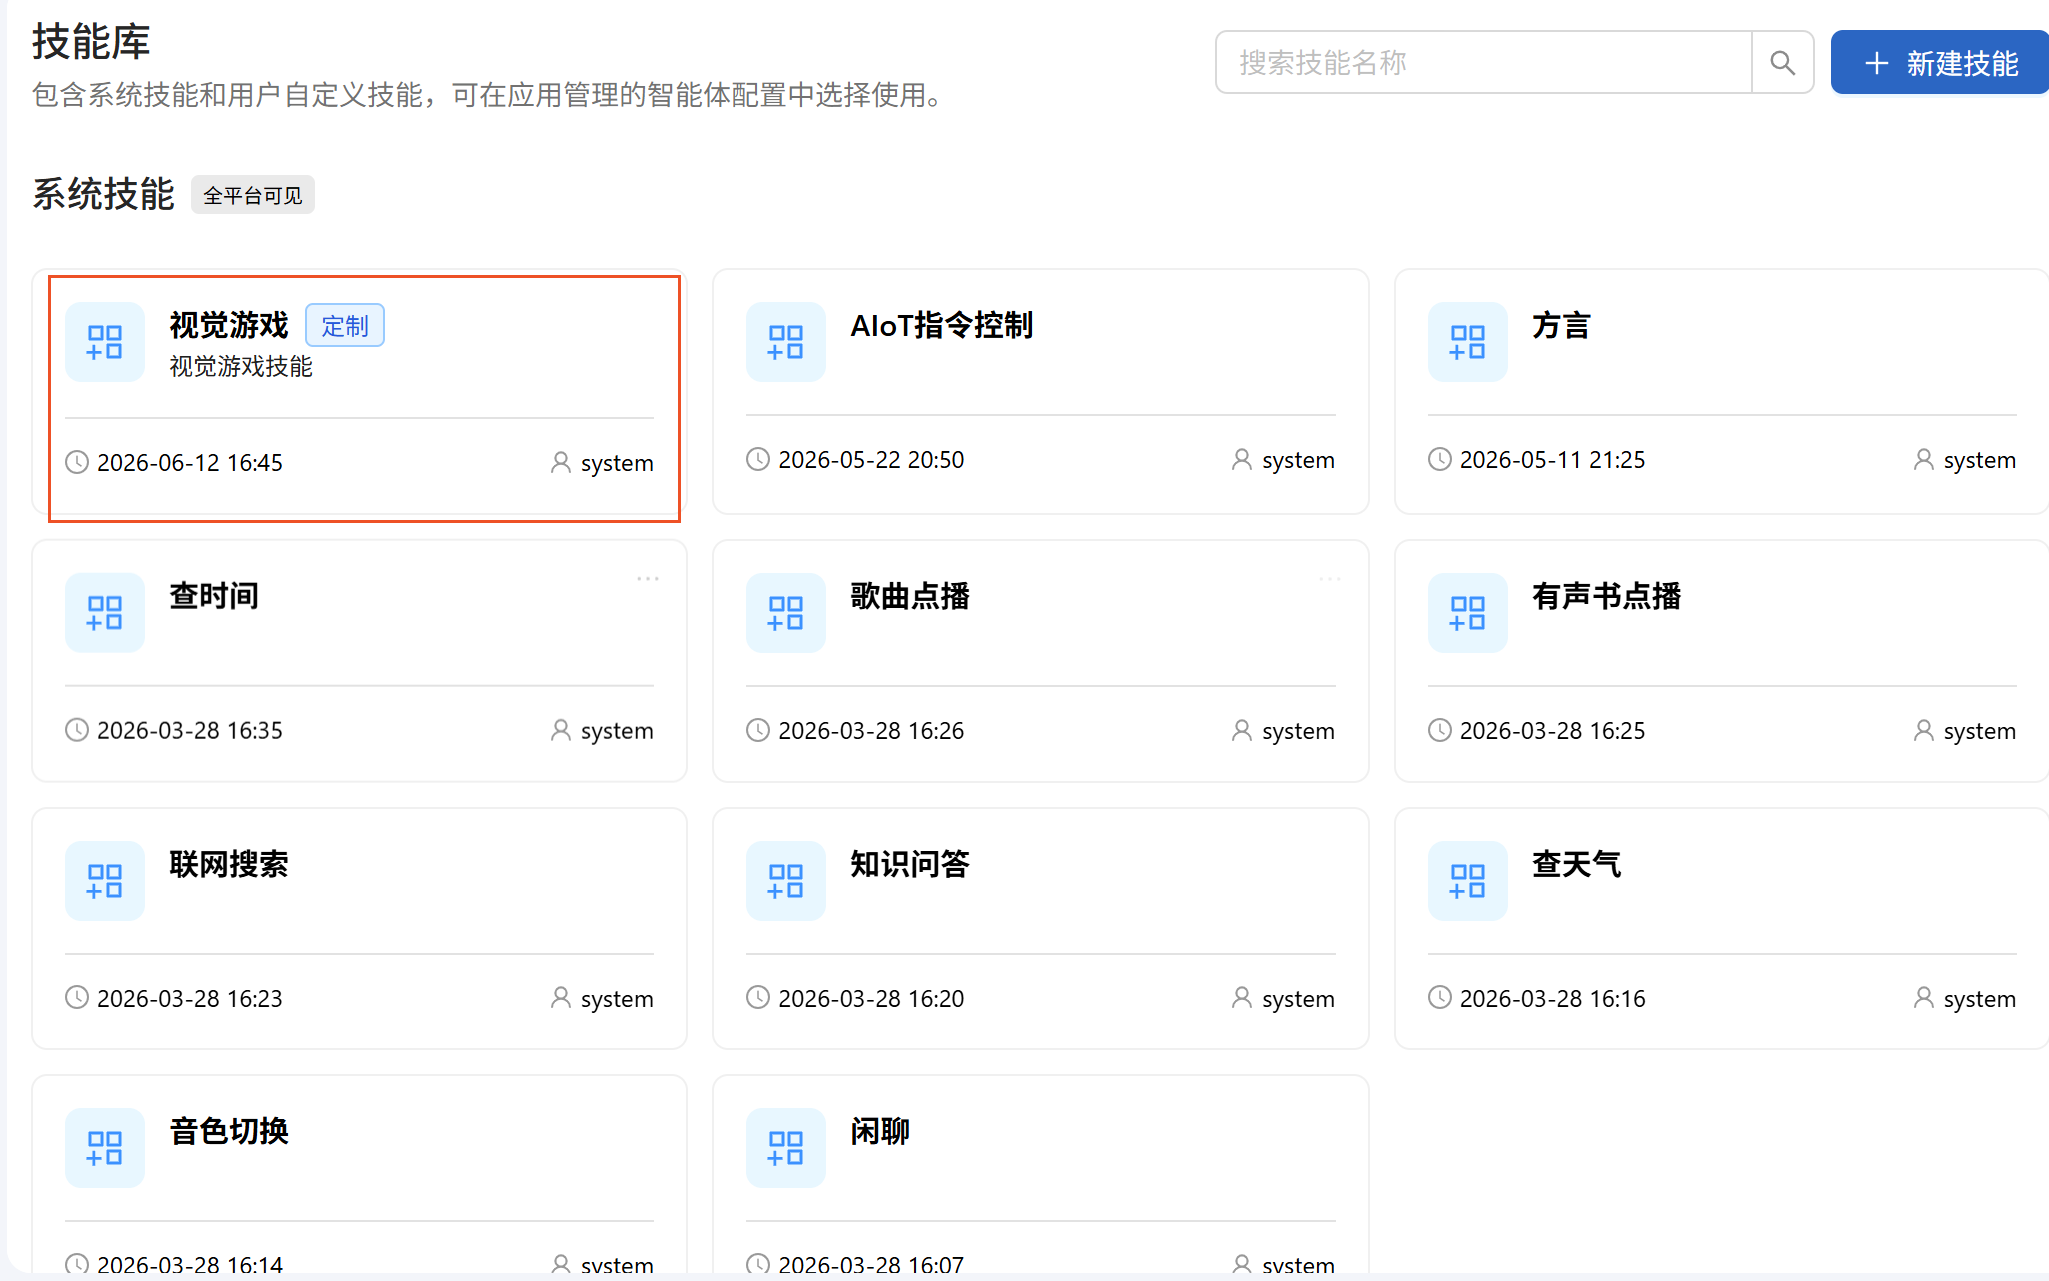
- 定制特殊智能体(技能):视觉识别场景 需先联系 JoyInside 运营人员协助申请开通权限,然后完成选择
视觉游戏智能体技能接入。
- 定制特殊智能体(技能):视觉识别场景 需先联系 JoyInside 运营人员协助申请开通权限,然后完成选择
- WebSocket 语音链路接入:完成基础链路对接(带
needAsrPartial=true,见 §6.4.2) - 视觉图像上传:按 §6.4.3 时机上传,调用 §6.4.4 的 image/report API
- 配网功能:非 JoyInside 标准盒子需自行配网;标准盒子可用 JoyAI 小程序配网
下一步
- 视觉对话排查:读 第 9 章 故障排查 —— 图像不关联对话(sessionId 不一致)/ 视觉识别不生效
- 回看 WS 建联:读 4.4 WebSocket语音通道 —— 建连参数,对话模式
- 服务端链路:读 4.6 服务端链路设计 —— 会话上下文缓冲区
- 其他场景:读 6.1 指令与控制 / 6.2 媒体资源接入 / 6.3 魔法打印接入